この記事でわかること
- 主な性能差と、評価条件の読み方が分かります。
- 使えるプラン・料金と、公開特典との違いが分かります。
- 今のモデルと同じ課題で試す進め方が分かります。
Claude Fable 5.2は、複雑な開発や調査、工程の長い仕事に向けて、推論や図表の読み取り、業務処理の性能を高めたモデルです。Fable 5.1より出力が速く、API料金も下がりましたが、すべての業務でOpus 5.5を上回るわけではありません。普段の仕事はまずOpus 5.5で試し、難しい課題だけをFableと比べる進め方が、公式でも案内されています。
新しいモデルの発表を見て、「性能は上がったようだが、毎日の資料づくりにも必要なのか」と迷うことがあります。この記事は、性能の意味、使える条件、自社で試す仕事の順で、判断の材料を整理します。公式の数値と利用条件をもとにした整理で、当サイトが自社業務で測った結果ではありません。
この記事でわかることは、次の3点です。
- 主な性能差と、評価条件の読み方
- 使えるプラン・料金と、公開特典との違い
- 今のモデルと同じ課題で試す、小さな試用の進め方
01
Claude Fable 5.2は、何に向くモデル?
Claude Fable 5.2は、2026年11月9日に公開されたモデルです[1]。はじめに押さえておきたいのは、モデルを選ぶことと、それを使う環境を用意することは別だという点です。Claudeには、チャット、Cowork、Code、APIといった入口がありますが、これらは使い方や機能の違いです。モデルをFableに変えるだけで、パソコンの操作や社内システムとの接続が自動でできるようになるわけではありません。実際にどこまで実行できるかは、使う環境と与えた権限で決まります。
難しい技術課題と、長い工程の仕事に向く
公式の発表では、Fable 5.2は、難しい技術課題や、複数の手順をまたぐ長い工程の仕事で性能を高めたモデルと位置づけられています[1]。これは、日常のすべての業務をこのモデルに置き換えることを勧めるものではありません。どんな仕事を、どこまで自動の手順に任せられるかは、モデルの性能だけでは決まらず、権限や確認の仕組みとあわせて考えます。モデルと、AIに手順を任せる仕組み(エージェント)の関係は、AIエージェントの基礎で解説しています。
普段の業務は、Opus 5.5から試す
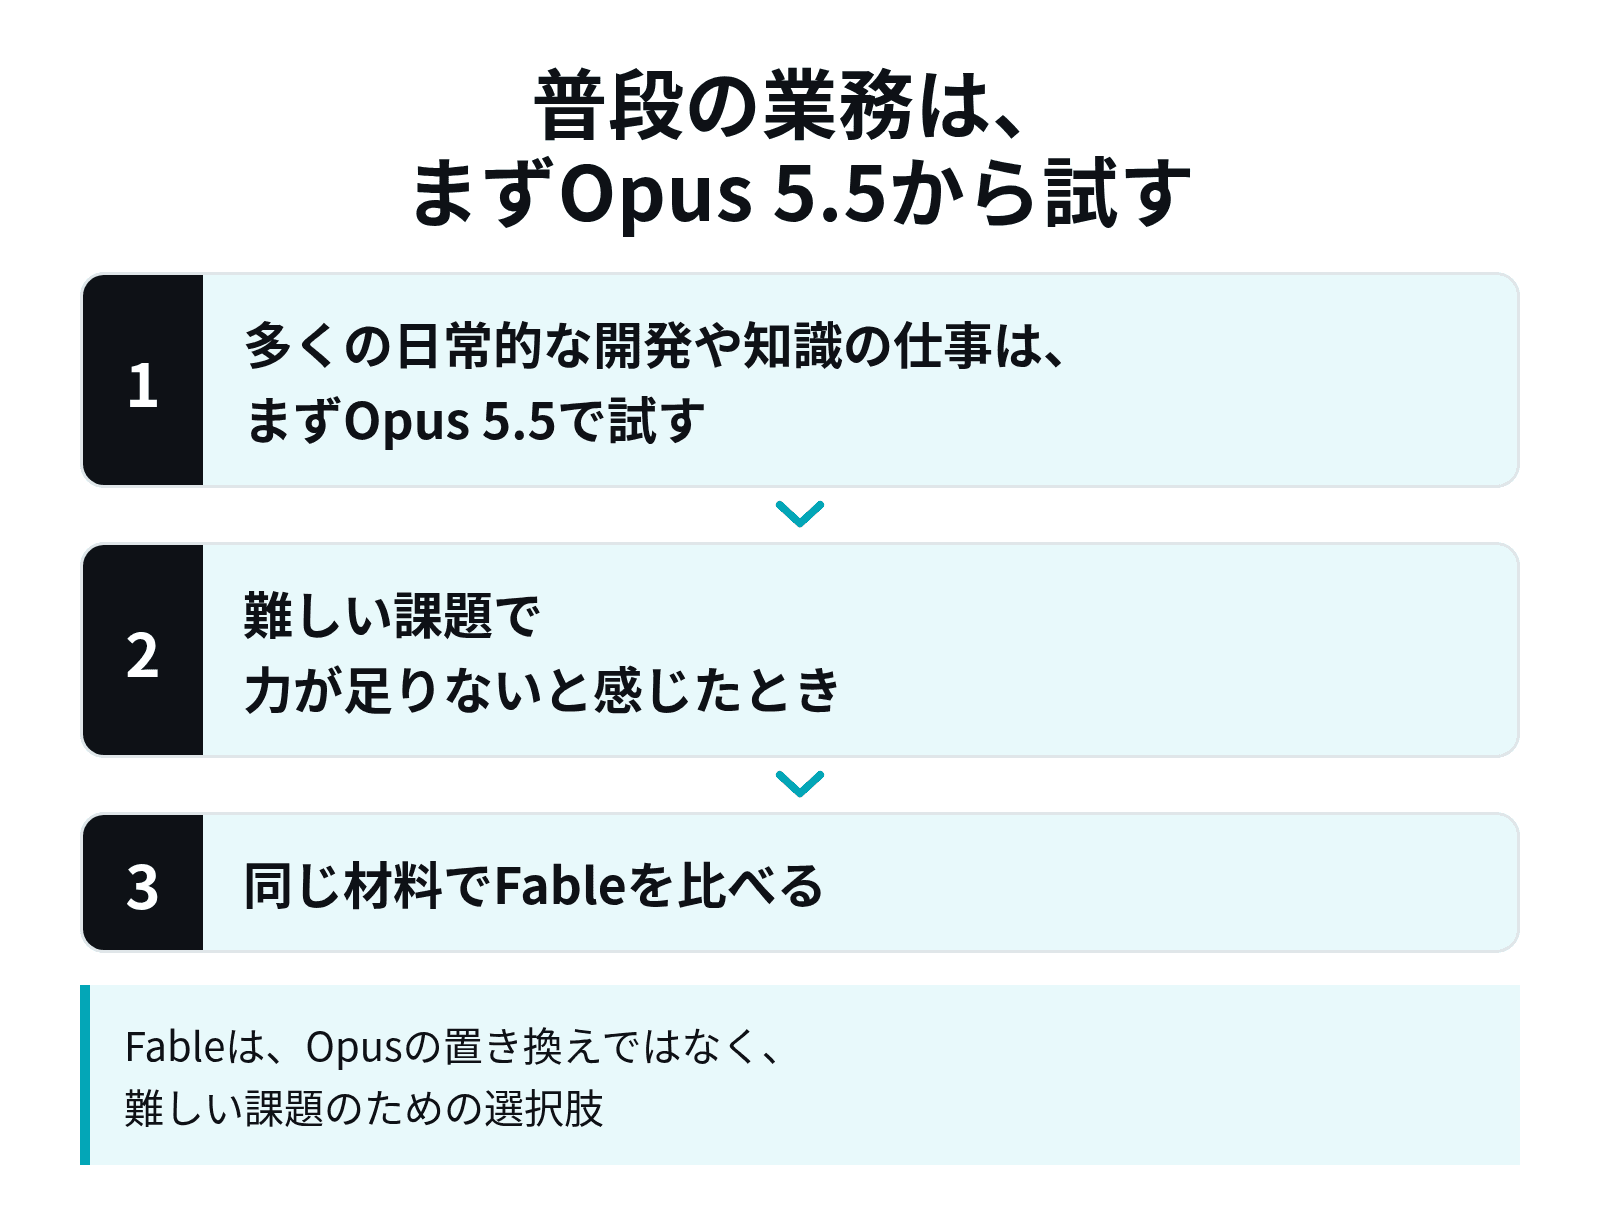
公式は、多くの日常的な開発や知識の仕事は、まずOpus 5.5で試すことを案内しています[1]。そのうえで、難しい課題で力が足りないと感じたときに、同じ材料でFableを比べる進め方を示しています。つまりFableは、Opusの置き換えではなく、難しい課題のための選択肢という位置づけです。Opus 5.5の基本や料金、業務での使い方は、Claude Opus 5.5のビジネス活用ガイドにまとめています。
02
性能はどこが変わった?公式ベンチマークの読み方
性能が上がったかどうかは、どの評価を、どんな条件で測ったかまで見ないと判断できません。ここでは、業務に関係しそうな評価をいくつか取り上げ、数字の読み方を整理します。点数の高さを、そのまま自社の仕事の成功率と読まないことが大切です。
Fable 5.1・Opus 5.5と同じ評価で比べる
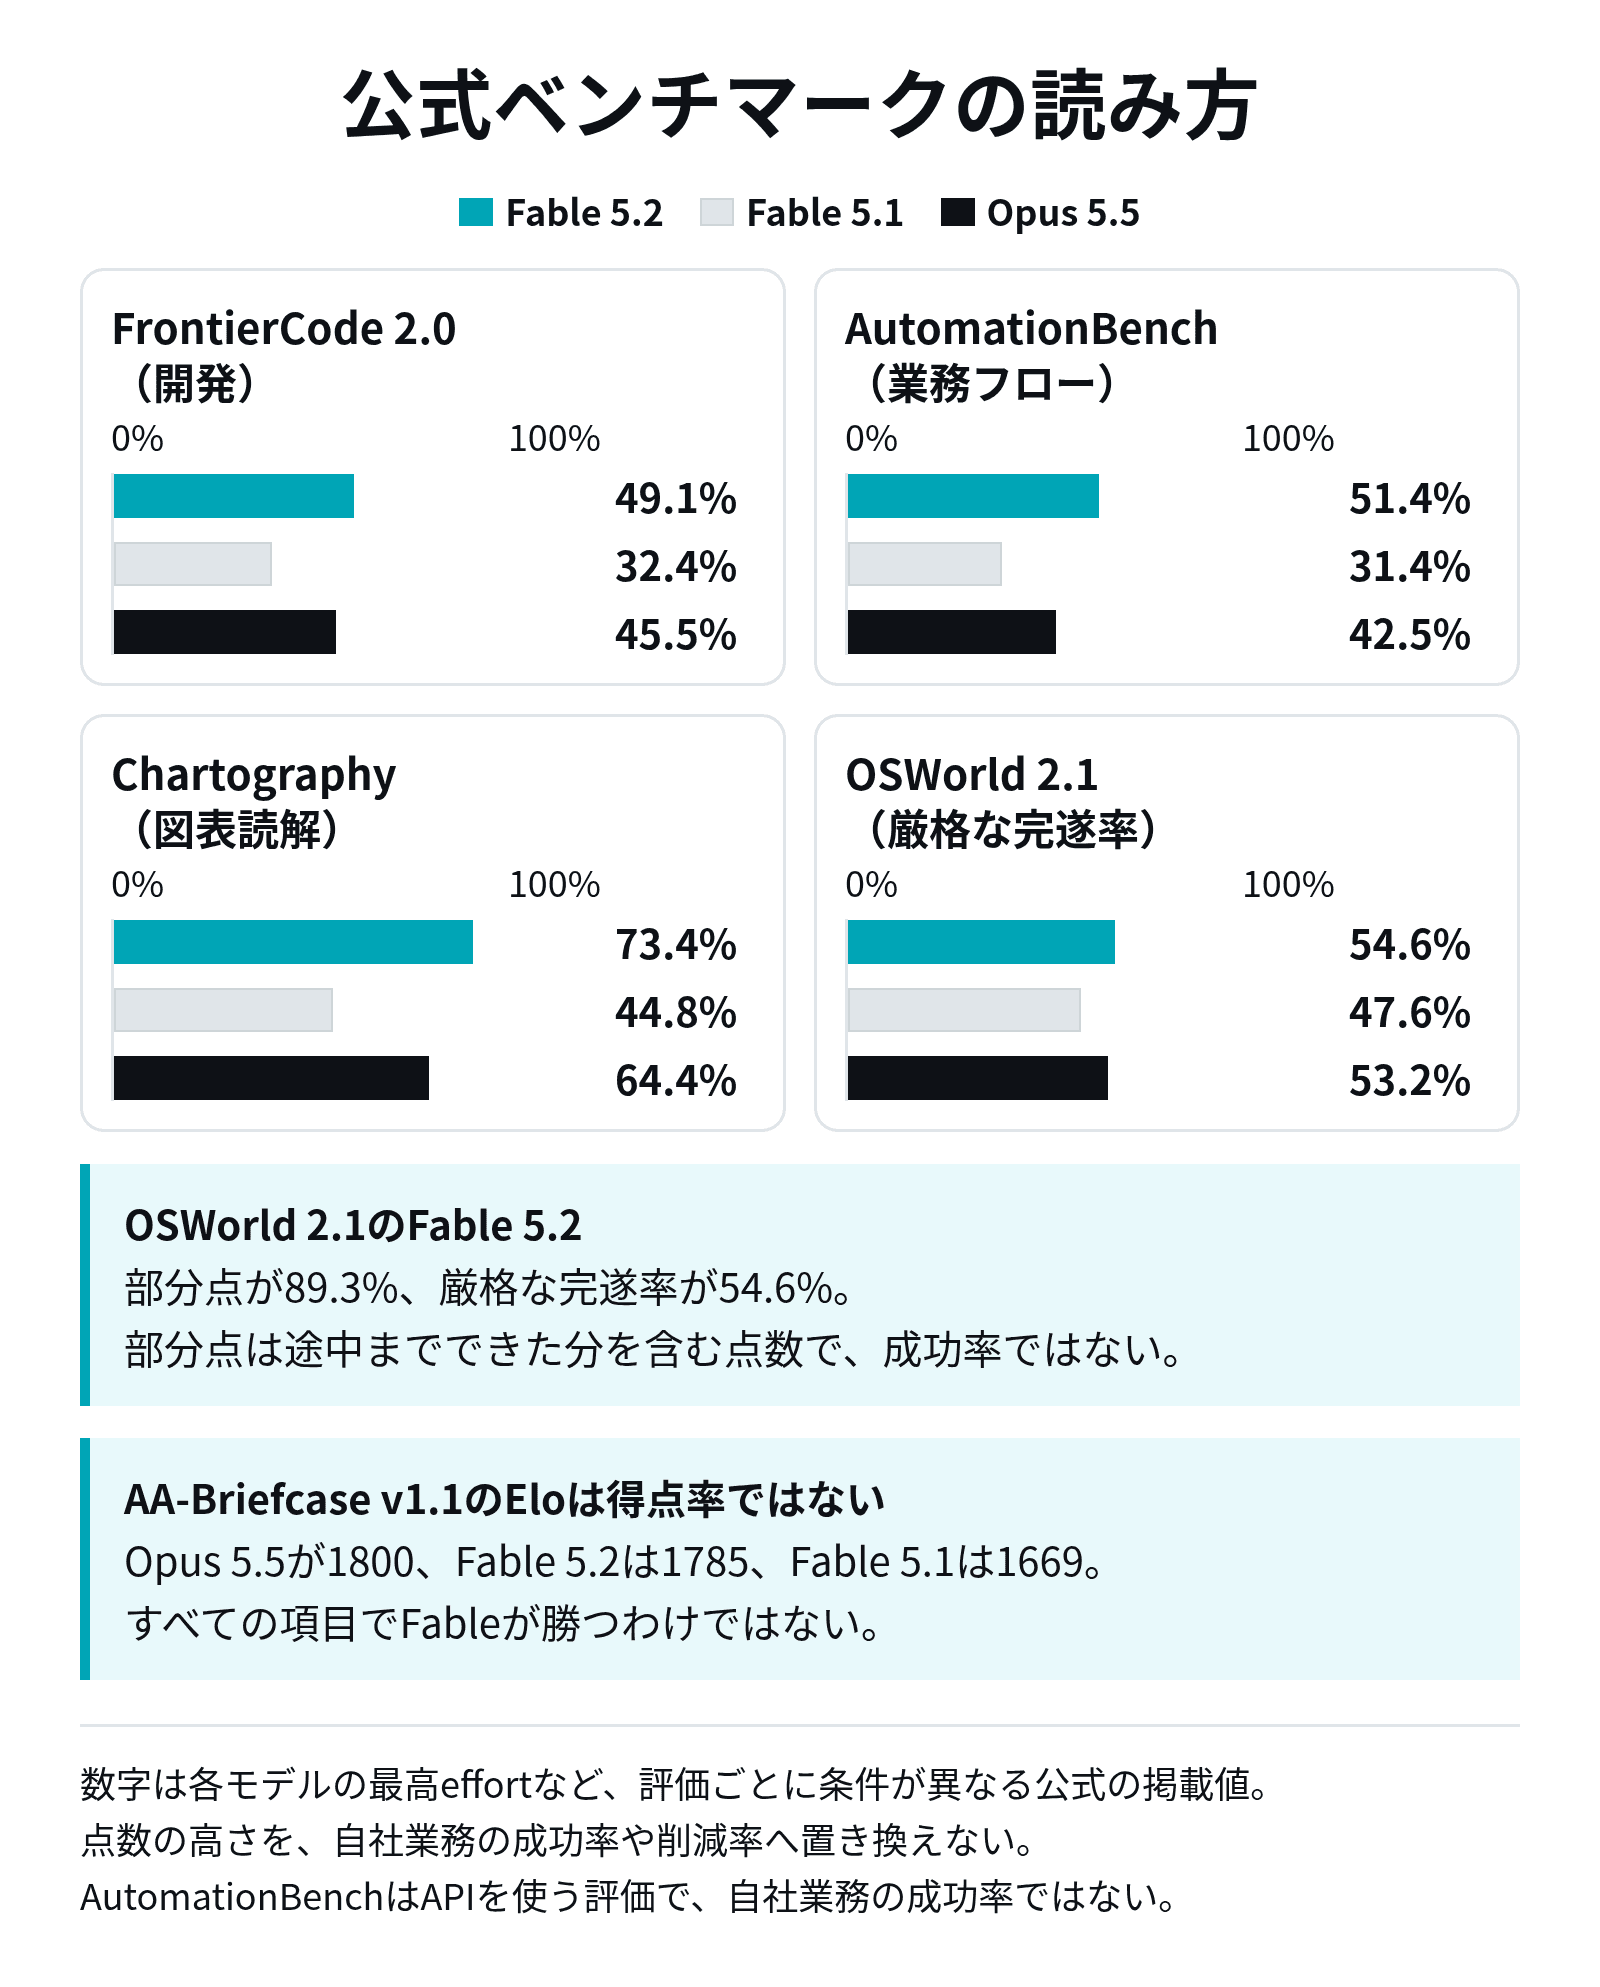
次の表は、公式の発表とシステムカードから、業務に近い評価を抜き出したものです。数字は公式の掲載値です。
| 評価(意味) | Fable 5.2 | Fable 5.1 | Opus 5.5 | 読み方の注意 |
|---|---|---|---|---|
| FrontierCode 2.0(開発) | 49.1% | 32.4% | 45.5% | 各モデルの最高effortでの結果 |
| AutomationBench(業務フロー) | 51.4% | 31.4% | 42.5% | APIを使う評価。自社業務の成功率ではない |
| Chartography(図表読解) | 73.4% | 44.8% | 64.4% | ツールなし。各モデル最高effort |
| Remote Labor Index(職業的タスク) | 41.3% | 17.9% | 21.3% | 労働時間の代替率ではない |
| OSWorld 2.1(部分点) | 89.3% | 83.5% | 87.2% | 途中までを含む点数。成功率ではない |
| OSWorld 2.1(厳格な完遂率) | 54.6% | 47.6% | 53.2% | 全確認項目を満たした割合 |
| AA-Briefcase v1.1(rubric) | 66.1% | 61.5% | 61.2% | 外部評価者の結果を公式が収録 |
| AA-Briefcase v1.1(Elo) | 1785 | 1669 | 1800 | 得点率ではない。Opusが上回る |
表の数字は、各モデルで使える最も高いeffort(考える深さを調整する設定)での結果など、評価ごとに条件が異なります[1][2]。effortを上げると、時間や費用も変わります。標準の設定どうしの比較と、最高得点どうしの比較を混ぜないようにします。ツールや評価の環境も結果に影響するため、条件のそろわない数字を並べて優劣を決めることはしません。
部分点・完遂率・評価条件を分けて読む
同じ評価でも、点数の意味が違うことがあります。たとえばOSWorld 2.1というパソコン操作の評価では、Fable 5.2の部分点は89.3%ですが、各課題のすべての確認項目を満たした厳格な完遂率は54.6%です[2]。部分点は、途中までできた分を含む点数です。これを「パソコン操作の成功率」と読むと、実際より高く見えます。AutomationBenchは、APIを使った業務フローの評価で、実際の自社業務の成功率とは別物です[1]。図表の読み取りを測るChartographyでは、Fable 5.2が73.4%、Opus 5.5が64.4%でした[1]。一方、ビジネスタスクをEloで比べるAA-Briefcaseでは、Opus 5.5が1800で、Fable 5.2の1785を上回っています[2]。すべての項目でFableが勝つわけではありません。数字の高さを、日本の会社の事務作業の成功率や削減率へ置き換えないようにします。
03
文脈長・速度・料金と、使えるプラン
ここでは、仕様と料金、そして使えるプランを分けて見ます。文脈長(一度の処理でまとめて参照できる範囲)やトークン(処理と課金の単位)は仕様の話で、料金やプランは契約の話です。次の表は、仕様と料金を整理したものです。
| 項目 | 公式の値 | 記事で残す条件 |
|---|---|---|
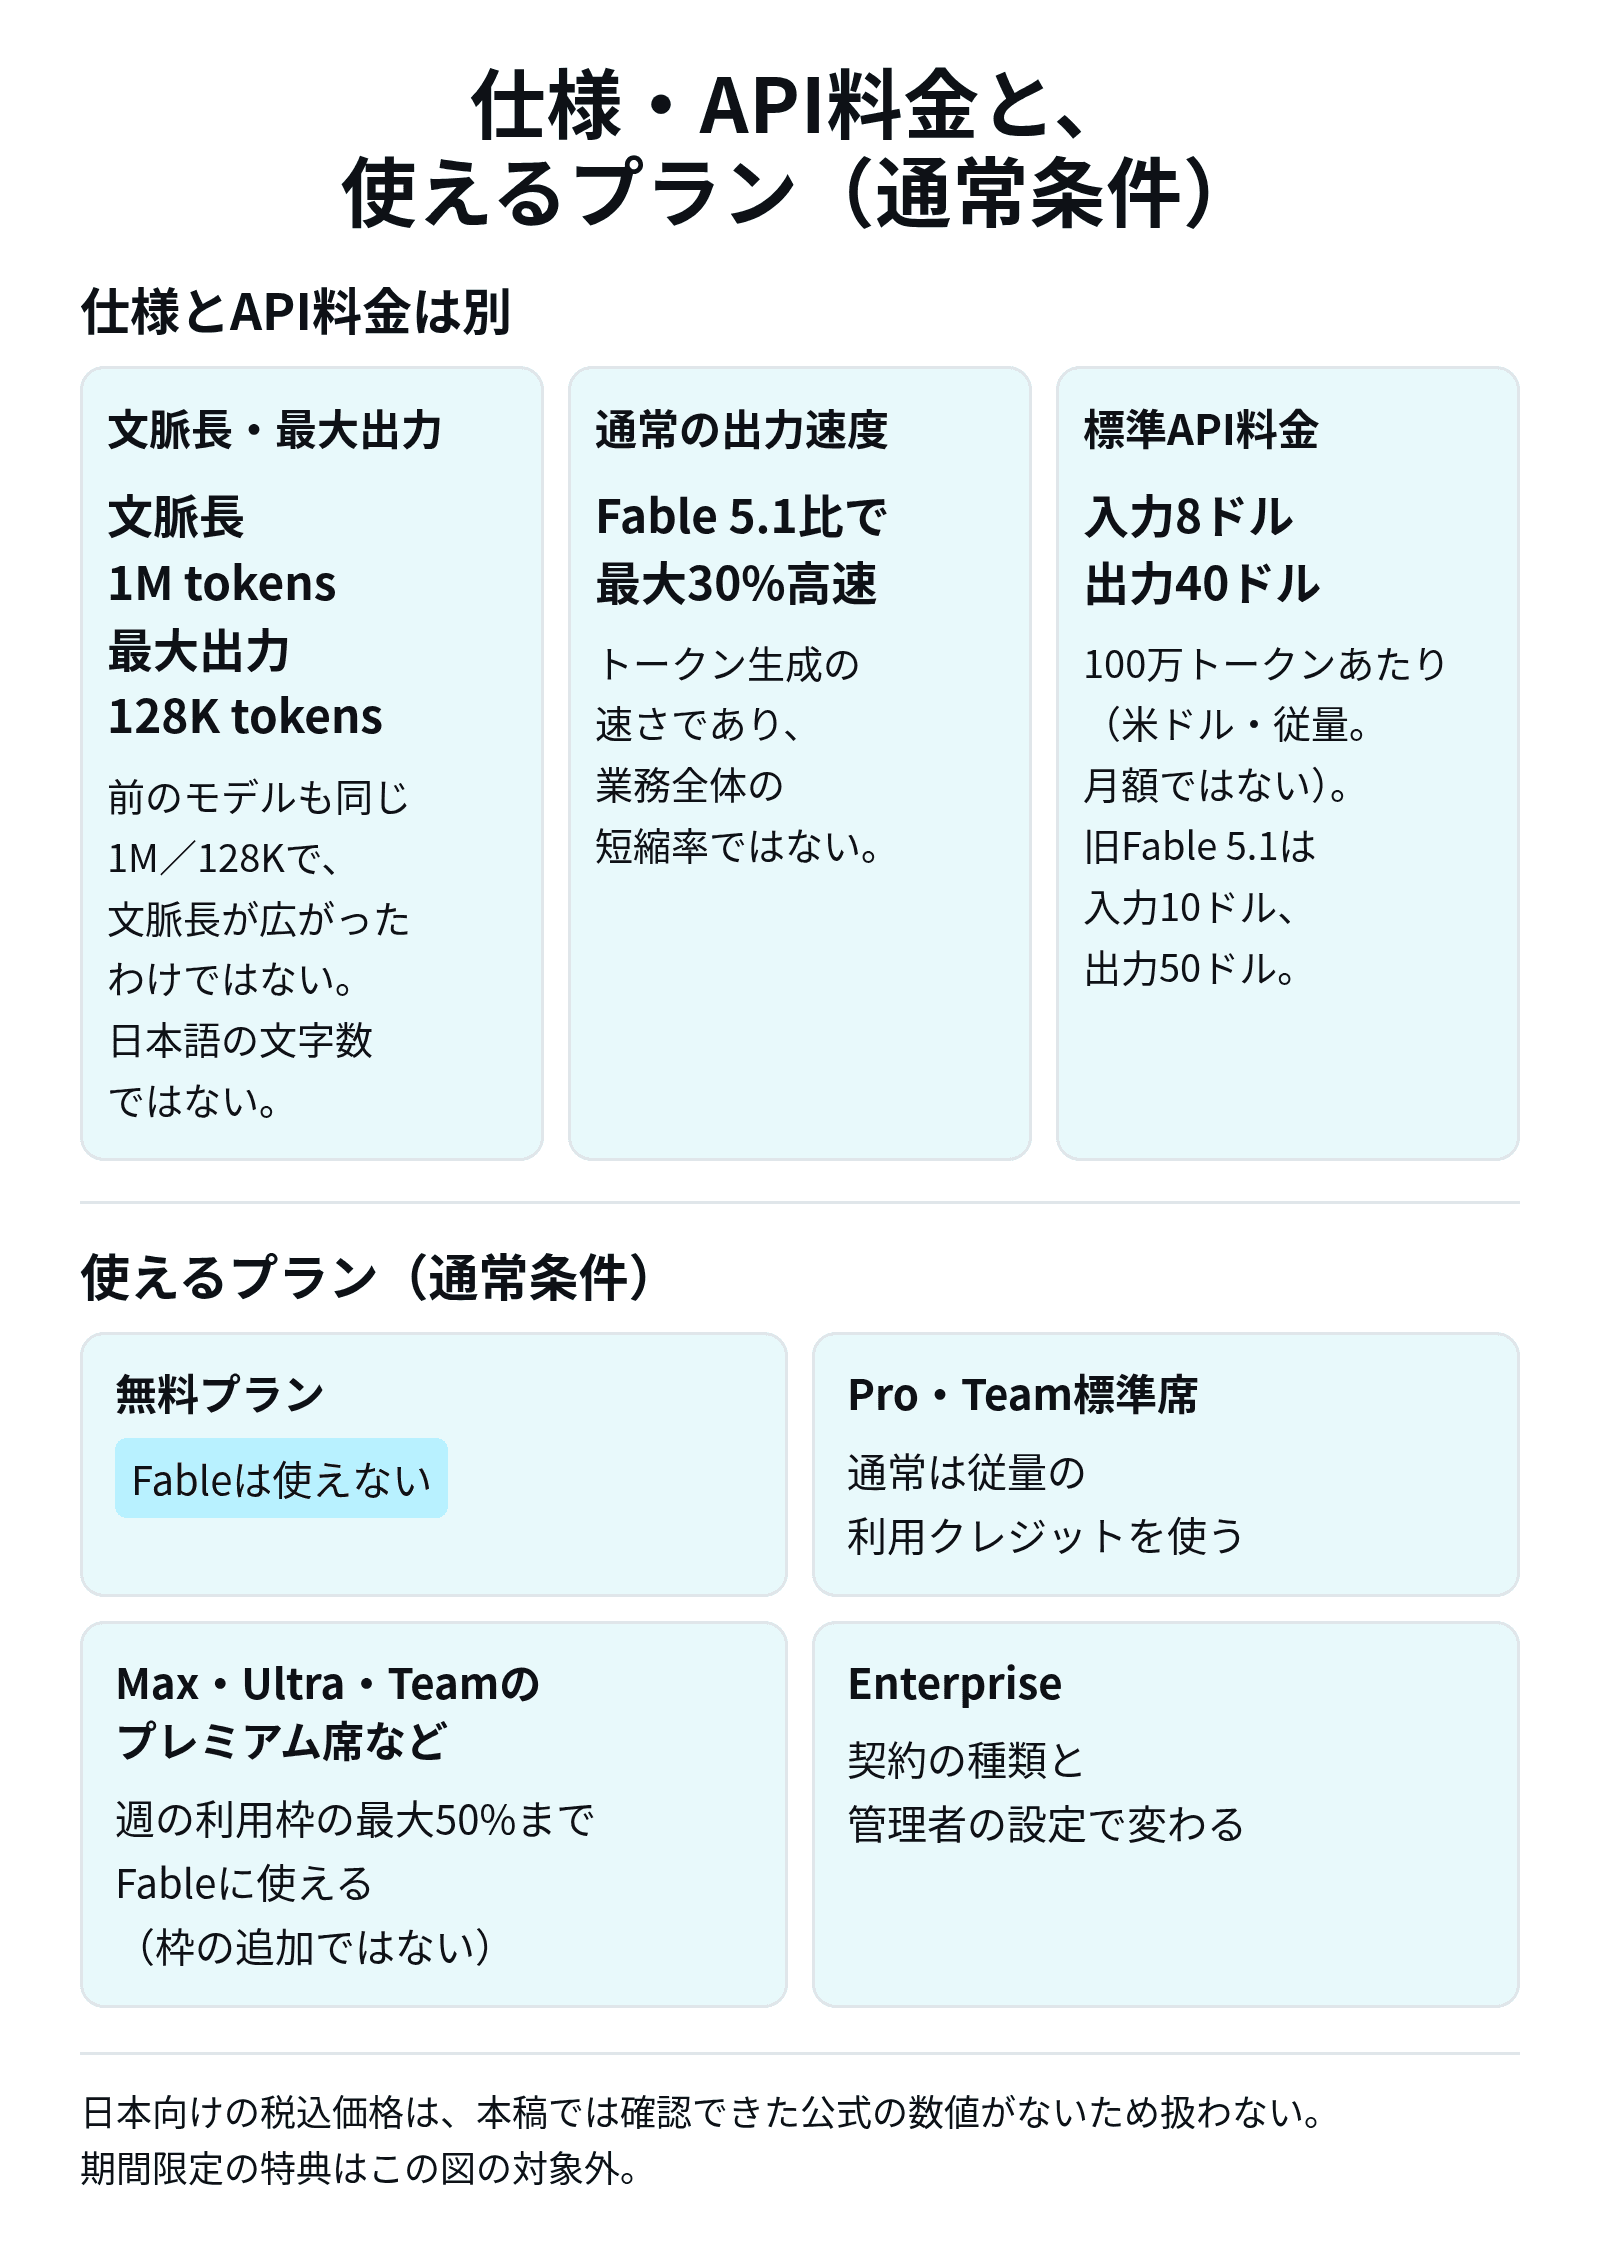
| 文脈長 | 1M tokens | APIの仕様。日本語の文字数ではない |
| 最大出力 | 128K tokens | 文脈長とは別の上限 |
| 前モデルの文脈長・最大出力 | 1M/128Kで同じ | 文脈長が広がったわけではない |
| 通常の出力速度 | Fable 5.1比で最大30%高速 | トークン生成の速さ。業務全体の短縮率ではない |
| fast mode | 1秒あたり出力が最大2.5倍 | 任意・割増料金。30%と掛け合わせない |
| 標準API料金(入力/出力) | 100万トークンあたり8ドル/40ドル | 米ドル・従量料金。月額ではない |
| 旧Fable 5.1(入力/出力) | 100万トークンあたり10ドル/50ドル | 同じ単位で前後を比較 |
| fast modeの料金(入力/出力) | 100万トークンあたり16ドル/80ドル | 追加の修飾料金は別途確認 |
| 提供開始日 | 2026年11月9日 | 公式の記載日。開始時刻は推測しない |
文脈長と出力速度は、仕事全体の時間とは違う
文脈長は1M tokens、一度に生成できる最大出力は128K tokensです[3]。これはAPIの仕様で、チャットに添付できる上限や、日本語の文字数そのものではありません。前のモデルも同じ1M/128Kで、文脈長が広がったわけではありません[4]。出力の速度は、Fable 5.1と比べて最大で30%高速とされています[1]。さらにfast mode(割増料金で速度を上げる任意の設定)では、1秒あたりの出力が最大2.5倍とされています[4]。ただし、これらはトークンを生成する速さの最大値です。資料づくり全体にかかる時間が、同じ割合で短くなる保証はありません。確認や修正の手間は、別に見積もります。
APIの従量料金と、契約プランを分ける
API料金は、使った分だけ払う従量制です。標準のAPI料金は、100万トークンあたり入力が8ドル、出力が40ドルです(米ドル)[5]。前のFable 5.1は入力10ドル、出力50ドルだったので、同じ単位でそろえると下がっています[5]。fast modeを使う場合は、入力16ドル、出力80ドルです[5]。これはAPIの従量料金で、月額プランの料金や、1案件あたりの費用とは別のものです。日本向けの税込価格は、本稿では確認できた公式の数値がないため扱いません。使えるプランは、次のように分かれます。
| プラン・席 | 確認できた条件 |
|---|---|
| 無料プラン | Fableは使えない |
| Pro・Team標準席 | 通常は従量の利用クレジットを使う |
| Max・Ultra・Teamプレミアム席など | 週の利用枠の最大50%までFableに使える(枠の追加ではない) |
| Enterprise | 契約の種類と管理者の設定で変わる |
無料プランでは、Fableをそのまま使うことはできません[6]。Pro・Team標準席は、通常は追加の利用クレジットでFableを使います。Max・Ultra・Teamのプレミアム席などは、通常の週の利用枠の最大50%までをFableに充てられますが、これは枠を増やすものではありません[6]。Enterpriseは、契約の種類(席ごとの課金か従量課金か)や、管理者がモデルを有効にしているかで変わるため、社内の管理者に確認します[6]。
公開記念の特典は、別枠で確認する(期間限定)
なお、公開を記念した期間限定の特典があります。この段落は特典の案内で、前の段落までの通常条件とは別です。Pro・Team標準席では、公開から2026年11月16日 23時59分(米国太平洋時間、PT)まで、週の利用枠の最大50%にFableを含められるとされています[7]。対象の契約によっては、利用枠のリセットに関する特典もありますが、回数や期限は契約ごとに異なるため、詳しくは公式の案内で確認します[7]。この特典の期間が過ぎたあとは、前の段落までの通常条件で判断します。
どの業務で試すか迷うときは、23問・約5分の無料AI活用診断で、最初に試す業務の候補が分かります。結果の表示には、かんたんな登録があります。診断は、特定のモデルが自社に合う保証ではありません。
04
普段の業務では、どの仕事で試す?
ここからは、普段の業務で試す候補を挙げます。これらは編集部が考えた例で、製品が対応するアプリや精度を保証するものではありません。どの仕事でも、同じ素材・指示・完成の条件で、今使っているモデルと比べることが前提です。次の表は、仕事ごとの試し方を整理したものです。
| 業務 | 試す依頼 | 人が確認すること | 切替の判断に残す記録 |
|---|---|---|---|
| 公開資料からの取引先候補の条件整理 | 出典の位置と、不明な条件の欄を残して整理 | 根拠の一致、資料どうしの矛盾 | 確認・修正にかかった手間 |
| ダミーの月次報告の図表確認 | 軸・単位・凡例と数値を説明 | 原表との照合、合計や期間の誤り | 誤読や不足の内容 |
| 検証用データでの社内台帳更新の試作 | 更新予定の一覧まで作成(実更新はしない) | 対象・変更内容・重複・戻し方 | 工程ごとの完了と手戻り |
資料が多く、条件の食い違いを探す調査
資料の点数が多く、条件の食い違いを見つける調査は、長い文脈を参照する仕事なので、性能が関係しやすい入口です。たとえば、公開資料から取引先候補の条件を整理する作業では、出典の位置と、条件が不明な欄を残したまま並べてもらいます。人は、挙がった根拠が原典と一致するか、資料どうしで矛盾がないかを確かめます。試す仕事の洗い出しには、業務棚卸しシートが使えます。
図表の読み取りと、集計・報告の下書き
図表の読み取りと、集計や報告の下書きも、候補になります。ダミーの月次報告を使い、軸・単位・凡例と数値の関係を説明してもらい、人が原表と照合します。合計や対象期間の取り違えがないかも確かめます。表計算の一般的な進め方が必要な部分は、ExcelでのAIの使い方を参照してください。実際の社外秘のデータは使わず、公開資料や、会社が許可したダミー資料から始めます。
複数工程の自動化は、試験環境で確かめる
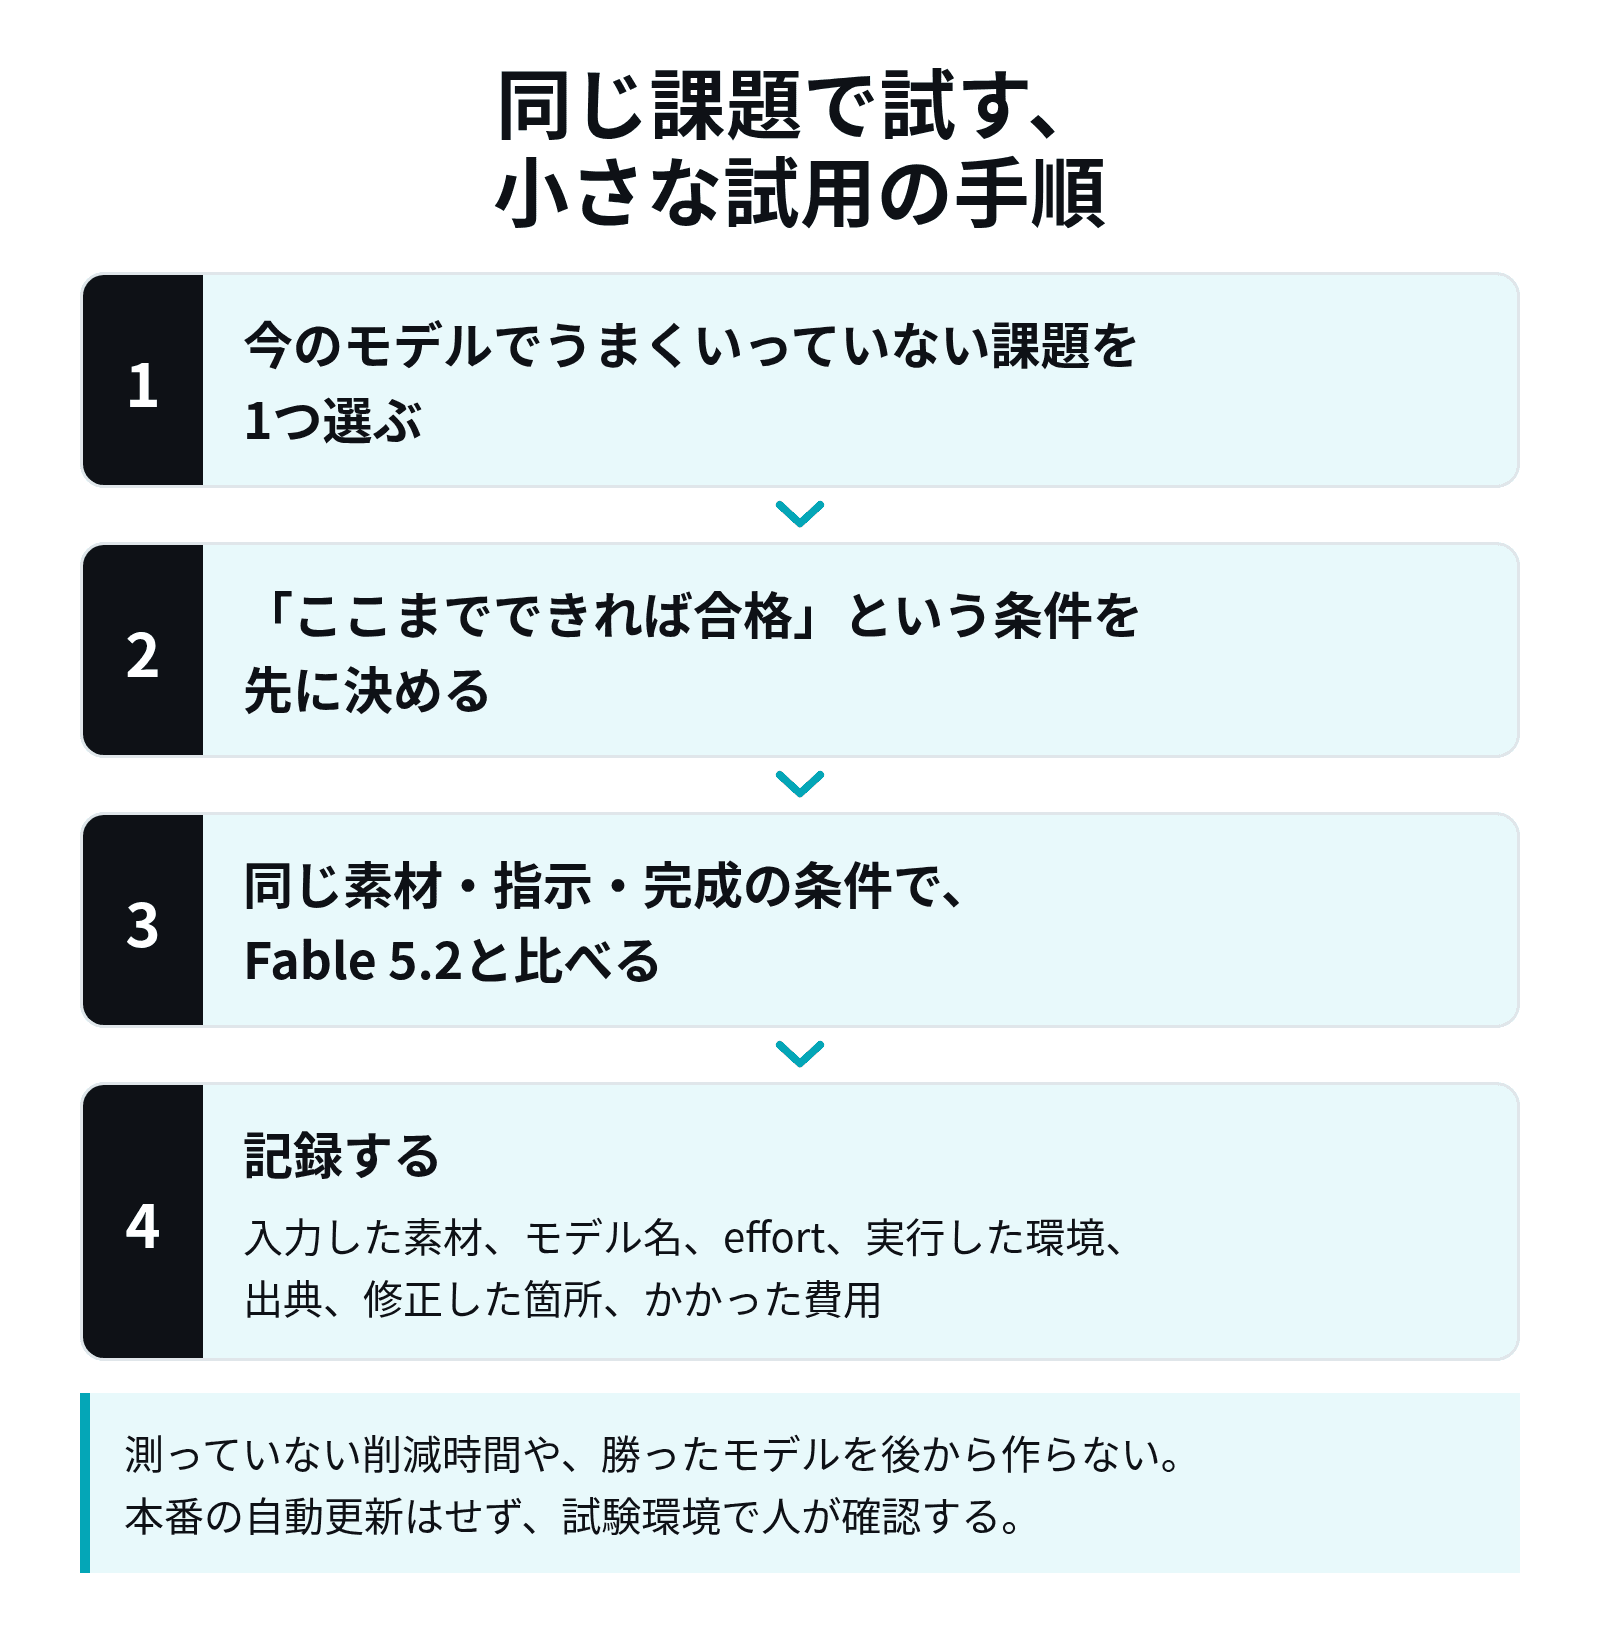
複数の工程をまたぐ自動化は、いきなり本番で動かさず、試験環境で確かめます。たとえば、検証用のデータを使って社内台帳の更新を試すときは、更新予定の一覧を作るところまでにとどめます。台帳の実際の更新は、人が内容を承認したあとに行う設計にします。対象、変更の内容、重複、戻し方を工程ごとに確認します。この手順が動くかどうかは、使う環境の対応機能によります。比べるときは、入力した素材、モデル名、effort、実行した環境、出典、修正した箇所、かかった費用を記録します。先に「ここまでできれば合格」という条件を決めておき、測っていない削減時間や、勝ったモデルを後から作らないようにします。
05
Mythos 5.2との違いと、社内データの注意点
Mythos 5.2という名前を見かけることがあります。Fableとの違いと、社内のデータを扱うときの注意点を整理します。
基盤モデルは同じでも、安全策と対象が違う
Mythos 5.2とFable 5.2は、同じ基盤モデルで、仕様も料金も同じです[3]。主な違いは、サイバーや生物に関わる領域の安全策と、使える対象です。Fableは、これらの領域で強い安全策がかかっており、専門的な作業がブロックされることがあります[2]。Mythosを直接使えるのは、検証を経た組織に限られます。EnterpriseでClaude Securityを使うことと、Mythosを自由に直接使うことは、別の話です。なお、この記事では、ブロックを避ける手順は扱いません。Mythosの専門評価の点数を、Fableの性能として紹介することもしません。
保存条件・権限・確認者を先に決める
社内のデータを使う前に、保存の条件と、誰がどこまで操作できるかの権限、そして誰が結果を確認するかを決めます。APIでは、データの保持は原則30日で、保存しない扱い(ZDR)にするにはAnthropicの明示的な許可が必要です[3]。「学習に使われない」ことと「保存されない」ことは、同じではありません。EFSという仕組みはprivate betaの段階で、すべての契約が自動的に保存しない扱いになるわけではありません。業務のテストは、公開資料やダミー資料から始めます。社内ルールの作り方は、生成AIの社内利用ガイドラインの作り方で解説しています。
社内のどの情報を誰に任せるかは、運用の設計で決まります。法人向けの無料セキュリティ診断で、社内の確認点を整理できます。結果の受け取りには、会社名と会社メールの登録が必要です。安全を保証する診断ではありません。
06
よくある質問
Claude Fable 5.2は何が変わりましたか?
複雑な開発や調査、図表の理解、業務フローなどの評価が改善し、出力の速度やAPI料金も更新されました。ただし評価ごとに条件が違い、すべての項目で最良というわけではありません。数字は、記載された評価条件での結果です。
無料プランやProでも使えますか?
無料プランではFableを使えません。Pro・Team標準席では、通常は追加の利用クレジットを使います。プランや席ごとの条件は変わることがあるため、利用前に公式のプラン案内で確認してください。
Fable 5.2とOpus 5.5は、どちらを選べばいいですか?
公式は、多くの日常的な開発や知識の仕事を、まずOpus 5.5から始めることを案内しています。難しい課題で力が足りないときに、同じ材料でFableを比べます。順位で一律に決めるより、自社の課題で試して選ぶほうが確かめやすくなります。
Mythos 5.2はFableより高性能ですか?
同じ基盤モデルで、仕様も料金も同じです。主な違いは、サイバー・生物領域の安全策と、使える対象です。Mythosの専門的な評価の点数を、Fableの性能として扱うことはしません。
文脈長はどれくらいですか?日本語でも精度は同じですか?
APIの文脈長は1M tokensです。これは日本語の文字数の上限とは異なります。日本語だけの業務での精度は、本稿では確認できていません。多言語の平均値がその保証にもならないため、自社の資料で確かめてください。
パソコン操作をそのまま任せられますか?
モデルの能力だけでは、実行する環境は揃いません。OSWorldは、限られた試験条件での結果です。権限と試験環境を用意し、更新前の一覧と、実行後の結果を人が確認する設計にします。
07
まとめ
Claude Fable 5.2は、難しい課題や工程の長い仕事で性能を高めたモデルです。判断は、性能の表を見る、契約の条件を確かめる、同じ課題で今のモデルと比べる、の順で進めます。日常の作業まで、すべてをFableに切り替える必要があるわけではありません。
今日やることは1つです。今のモデルでうまくいっていない課題を1つ選び、合格の条件を決めて、同じ材料でFable 5.2と比べる小さな試用を設計してください。
どの仕事から試すか、どの環境で動かすか迷うときは、無料の個別相談をご利用ください。お申込みと無料会員登録を同時に行い、日程は担当者と調整します。成果や日程を確約するものではありません。
※この記事の内容は、2026年11月11日に、Anthropicの公式資料(発表・モデル仕様・料金・プラン・システムカード)で確認したものです。性能値は記載した評価条件での結果で、自社業務での精度や所要時間を保証するものではありません。期間限定の特典やプランの条件は変更されることがあるため、利用前に公式情報をご確認ください。